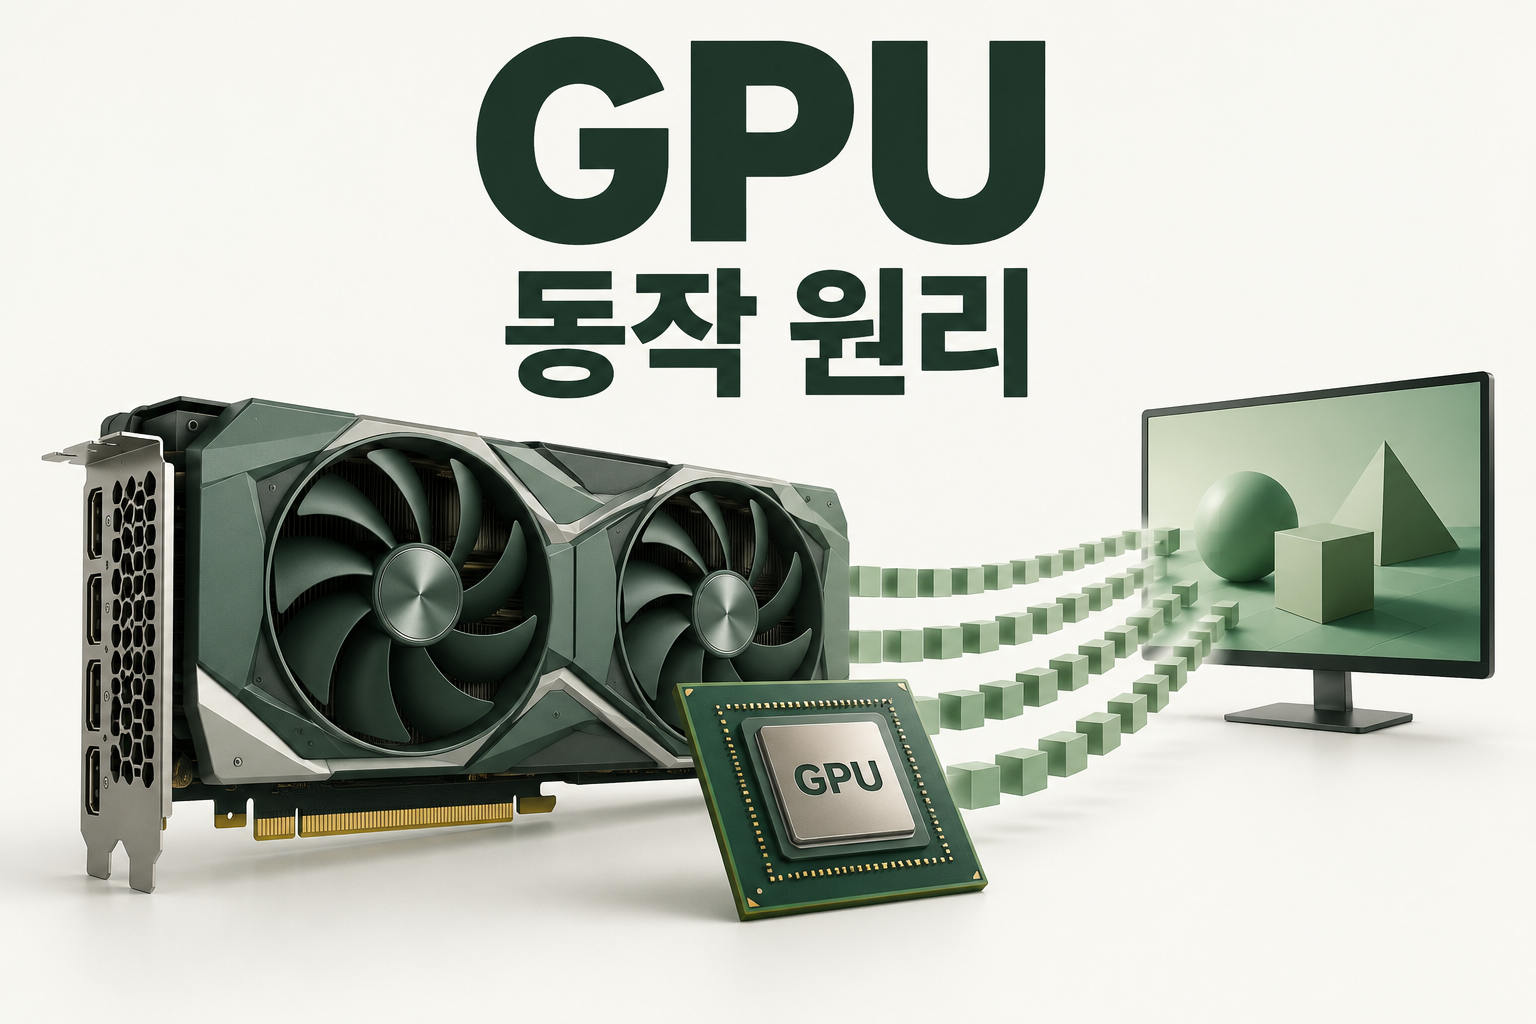
- GPU는 많은 데이터로 나눌 수 있는 계산을 여러 실행 자원에 분배해 처리합니다.
- 화면을 그릴 때에는 도형의 위치와 픽셀에 들어갈 값 등을 단계적으로 계산합니다.
- 빠른 처리를 위해서는 병렬로 나누는 방법뿐 아니라 메모리 접근과 작업 준비 비용도 중요합니다.
게임 화면은 계속 바뀌고, 사진 편집 프로그램은 수많은 점의 색을 한꺼번에 바꿉니다. 이런 작업을 돕는 장치가 GPU(Graphics Processing Unit), 그래픽 처리 장치입니다. 핵심은 화면이라는 이름보다 많은 계산을 나누어 처리하는 구조에 있습니다. 이 글에서는 먼저 화면이 만들어지는 과정을 보고, GPU 내부에서 일이 나뉘는 원리를 살펴보겠습니다.
1. 많은 데이터에 적용할 계산을 나눕니다
사진의 모든 픽셀에 같은 방식의 밝기 조정을 적용한다고 생각해 보겠습니다. 단순한 밝기 조정이라면 각 픽셀의 새 값을 다른 픽셀과 독립적으로 계산할 수 있습니다. GPU는 이런 일을 작은 작업으로 나누고, 여러 실행 자원에서 처리하도록 구성할 수 있습니다.
프로그램이 만든 모든 작업이 물리적으로 정확히 같은 순간에 실행되는 것은 아닙니다. 실행할 작업 수가 하드웨어 자원보다 많으면 나누어 배치됩니다. 여기서 병렬 처리의 장점은 작업 하나의 시간만 줄이는 데 있지 않고, 일정 시간에 많은 데이터를 처리하는 데 있습니다.
사진 1,000장에 같은 방식의 도장을 찍는 일을 여러 작업대에 나눠 맡긴다고 생각해 보세요. 작업대가 10개라면 전체 사진을 한꺼번에 1,000장 처리하는 것이 아니라, 각 작업대가 맡은 사진을 차례로 처리하며 함께 진행합니다.
GPU는 많은 계산을 나눠 배치하고 실행해 전체 데이터 처리량을 높입니다.
2. 게임 속 도형은 어떻게 화면의 점이 될까요?
일반적인 3D 그래픽의 래스터화 방식은 몇 가지 큰 단계로 이해할 수 있습니다. 먼저 물체를 이루는 점인 정점의 위치를 계산합니다. 다음으로 삼각형 같은 도형이 화면의 어느 부분을 덮는지 구합니다. 이 과정이 래스터화입니다.
이후 셰이더라는 프로그램으로 표면의 무늬나 빛 등을 계산하고, 깊이 검사와 색 혼합 등을 거쳐 화면에 쓸 결과를 만듭니다. 셰이더는 GPU가 실행하는 계산 프로그램이며, 그래픽 처리에는 이런 프로그램 가능한 단계와 정해진 기능의 하드웨어 단계가 함께 사용됩니다. [공식 근거: Microsoft의 그래픽 파이프라인]
즉 ‘GPU가 픽셀의 색을 계산한다’는 설명은 출발점으로는 좋지만, 화면의 점 하나마다 전용 코어 하나가 고정 배정된다는 뜻은 아닙니다. 도형이 겹치면 같은 화면 위치와 관련된 계산도 여러 번 생길 수 있습니다. 실제 렌더링에는 광선 추적 등 다른 기법을 함께 사용하기도 하므로, 이 흐름이 모든 그래픽 계산을 설명하는 것은 아닙니다.
화면은 위치 계산·도형의 화면 배치·색 계산·결과 결합 같은 여러 단계를 거쳐 만들어집니다.
3. GPU 안에서는 작업을 묶어서 실행합니다
일을 나누어 설명할 때는 스레드라는 개념을 사용합니다. 스레드는 프로그램 실행의 한 흐름이며, 물리적인 코어와 같은 뜻은 아닙니다. 예를 들어 NVIDIA의 CUDA에서는 여러 스레드를 블록으로 묶고, 블록들을 GPU의 실행 단위인 SM에 배치합니다.
SM은 여러 계산 장치와 레지스터, 캐시 등의 자원을 가진 처리 묶음입니다. CUDA의 SIMT 실행 모델에서는 스레드 32개를 워프(warp)라는 단위로 묶어 명령을 진행합니다. 여러 스레드가 같은 계산 절차를 서로 다른 데이터에 적용하는 방식입니다. 이것은 NVIDIA CUDA의 설명이며, 모든 회사 GPU의 실행 묶음 이름과 크기가 같다는 뜻은 아닙니다. [공식 근거: NVIDIA의 CUDA 실행 모델]
스레드가 서로 다른 조건을 만나 다른 경로로 가면, 같은 묶음의 실행 자원을 효율적으로 활용하기 어려워질 수 있습니다. GPU도 조건문을 실행할 수 있지만, 함께 처리하는 작업들이 비슷한 흐름을 따를수록 유리한 경우가 많습니다.
여럿이 같은 순서로 상자를 접으면 공통 안내에 맞춰 함께 움직이기 쉽습니다. 사람마다 접는 방식이 자주 달라지면 함께 진행하기가 까다로워집니다. 실제 GPU가 사람처럼 기다린다는 뜻이 아니라, 작업 흐름을 묶는 효과를 설명하는 비유입니다.
GPU의 스레드 수와 물리적 코어 수는 다르며, 작업을 어떻게 묶고 배치하느냐가 중요합니다.
스레드는 처리해야 할 개별 작업의 실행 흐름, 워프는 함께 진행하는 작업 묶음, SM은 이런 묶음들을 맡는 작업 구역처럼 볼 수 있습니다. ‘작업 1개 = 코어 1개’로 고정해 생각하기보다, 여러 작업이 제한된 실행 자원을 나누어 쓴다고 이해하면 좋습니다.
4. 계산할 데이터도 충분히 빨리 도착해야 합니다
GPU에 계산 장치가 많아도 데이터가 늦게 공급되면 성능이 제한됩니다. 외장 GPU는 보통 별도의 그래픽 메모리인 VRAM에 데이터와 결과를 보관합니다. GPU 내부의 레지스터와 캐시, 작업끼리 데이터를 공유하는 메모리 공간도 활용합니다. 내장 GPU는 시스템 메모리를 공유하는 구성이 흔하므로 모든 GPU가 독립된 VRAM을 갖는다고 보면 안 됩니다.
외장 GPU로 계산할 때는 CPU 쪽 메모리와 GPU 쪽 메모리 사이의 데이터 전달 비용도 고려해야 합니다. 모든 작업이 반드시 매번 복사로 시작하는 것은 아닙니다. 이미 GPU에 있는 데이터를 재사용하거나 시스템이 메모리 접근을 관리하는 방식도 있습니다.
메모리 용량은 얼마나 많은 데이터를 담는가, 대역폭은 일정 시간에 얼마나 많은 데이터를 옮길 수 있는가를 나타냅니다. 용량만 크다고 모든 계산이 빨라지는 것은 아닙니다. 접근하는 데이터의 배치와 재사용도 중요합니다. [공식 근거: NVIDIA의 메모리 최적화 안내]
GPU 성능은 계산 능력과 데이터 공급이 함께 맞아야 발휘됩니다.
5. GPU를 쓰면 어떤 프로그램이든 빨라질까요?
프로그램이 GPU를 활용하도록 작성되어 있어야 하며, 나눌 수 있는 계산이 충분해야 합니다. 앞 작업의 결과가 나와야 다음으로 갈 수 있는 일이 길게 이어지거나, 계산량에 비해 작업 준비와 데이터 이동 비용이 크면 이점이 줄어들 수 있습니다.
계산 결과를 CPU에서 사용할 필요가 있다면 완료를 기다리고 결과를 가져오는 과정도 필요합니다. GPU가 계산하는 동안 CPU가 다른 작업을 진행하도록 구성할 수도 있습니다. 따라서 GPU의 장점은 개별 계산 수치뿐 아니라 프로그램 전체에서 실제 시간을 얼마나 줄이는지로 판단해야 합니다. [공식 근거: NVIDIA의 GPU 처리 대상 선정]
이런 특성 때문에 GPU는 화면 처리 외에 대규모 배열·행렬 연산 등에도 활용됩니다. AI에 GPU가 쓰이는 이유도 이와 연결되지만, 모든 AI 연산이 GPU에서 수행되는 것은 아닙니다. 여기서는 GPU가 계산을 나누는 기본 원리까지 이해하면 충분합니다.
GPU가 빨라지려면 프로그램의 계산 방식과 데이터 흐름이 GPU 구조에 맞아야 합니다.
CPU와의 구체적인 역할 분담은 CPU와 GPU의 차이에서 이어서 살펴볼 수 있습니다.
- GPU는 많은 데이터에 적용할 계산을 나누어 여러 실행 자원에서 처리합니다.
- 일반적인 3D 래스터화에서는 정점·도형·픽셀 관련 계산과 결과 결합을 거쳐 화면을 만듭니다.
- 스레드와 코어는 같은 개념이 아닙니다. 스레드 32개를 워프 하나로 묶는 방식은 NVIDIA CUDA의 실행 모델입니다.
- 메모리 용량뿐 아니라 대역폭, 접근 방식, CPU와의 데이터 전달 비용도 중요합니다.
- 병렬화할 수 있는 계산과 이를 활용하는 프로그램이 함께 있어야 GPU의 장점이 커집니다.
Microsoft — 그래픽 파이프라인의 주요 단계
NVIDIA — CUDA 스레드·블록·SM·워프
NVIDIA — 병렬화와 메모리·데이터 전달 비용
생활 비유와 밝기 조정 예제는 이해를 돕기 위한 가상의 상황이며, 실측·사용자 후기가 아닙니다.