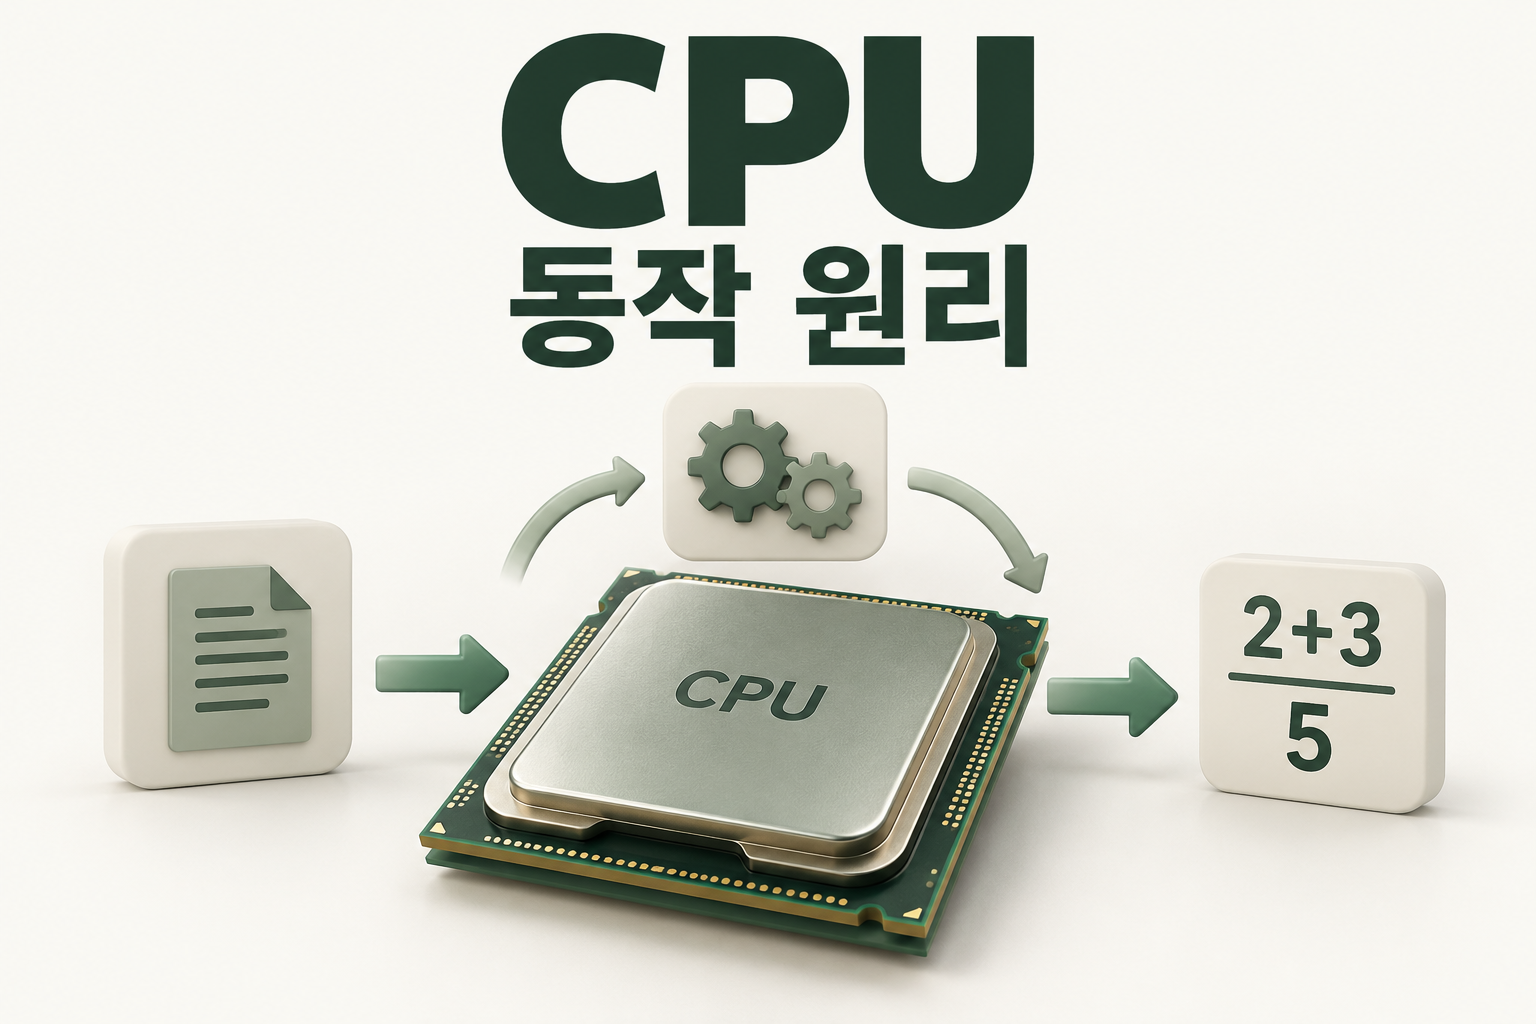
- CPU는 프로그램의 명령을 가져오고, 해석하고, 실행하며 컴퓨터의 일을 처리합니다.
- 레지스터와 캐시는 필요한 데이터를 가까이 두어 계산과 실행을 돕습니다.
- 성능은 클럭뿐 아니라 명령을 처리하는 구조, 코어 수, 데이터 대기 시간에도 영향을 받습니다.
계산기에 숫자를 입력하고 더하기를 누르면 답이 나타납니다. 문서의 글자를 지우거나 프로그램의 버튼을 누를 때도 컴퓨터 안에서는 명령이 실행됩니다. 이 명령을 처리하는 핵심 장치가 CPU(Central Processing Unit), 중앙 처리 장치입니다. CPU는 사람의 의도를 스스로 이해하는 대신, 정해진 형식의 명령에 따라 계산하고 데이터를 옮기며 실행 흐름을 바꿉니다.
1. CPU가 읽는 것은 프로그램의 명령입니다
우리가 보는 프로그램 화면과 CPU가 실행하는 명령은 다릅니다. 화면에서는 버튼 한 번을 누르지만, 내부에서는 숫자를 읽고, 비교하고, 더하고, 필요한 위치에 결과를 기록하는 여러 명령이 이어질 수 있습니다. 프로그래밍 언어로 작성한 코드는 컴파일이나 실행 환경의 처리 등을 거쳐 CPU가 실행할 수 있는 기계어 명령으로 이어집니다.
일반적인 PC에서 저장장치에 보관된 프로그램을 실행하면 필요한 코드와 데이터가 메모리로 준비됩니다. CPU는 캐시 등을 거쳐 명령과 데이터를 공급받습니다. 프로그램 전체를 CPU 안에 한꺼번에 넣고 실행하는 것은 아닙니다.
요리 앱에서 ‘볶음밥 만들기’를 누르는 것은 한 번이지만, 실제 조리에는 재료 꺼내기, 썰기, 볶기처럼 여러 단계가 필요합니다. 화면에서의 한 동작도 내부에서는 여러 명령으로 이루어질 수 있습니다.
CPU는 화면의 버튼 자체가 아니라, 그 동작을 구현하는 기계어 명령을 실행합니다.
2. 명령 가져오기 → 해석하기 → 실행하기 → 결과 기록하기
CPU의 기본 원리는 다음 네 단계로 이해할 수 있습니다. 실제 단계의 구분과 구성은 설계마다 다르지만, 명령을 처리하는 흐름을 잡는 데 유용합니다. [공식 근거: Arm의 명령 실행 과정]
- 가져오기(Fetch): 실행할 명령을 읽어 옵니다.
- 해석하기(Decode): 더하기인지, 데이터 이동인지, 조건에 따른 이동인지 등 명령의 의미와 필요한 자원을 구분합니다.
- 실행하기(Execute): 계산하거나 비교하고, 명령에 필요한 동작을 수행합니다.
- 결과 기록하기: 필요한 경우 결과를 레지스터나 메모리에 기록합니다.
예를 들어 두 숫자 2와 3을 더하는 상황을 생각해 보겠습니다. 값을 준비하고, 더하기를 수행하고, 결과 5를 다음 작업에서 쓸 수 있도록 남깁니다. 이것은 원리를 설명하기 위한 예이며, ‘2+3’이라는 글자 전체가 CPU의 명령 하나라는 뜻은 아닙니다.
프로그램에는 계산 외에 조건에 따라 다른 명령으로 이동하는 과정도 있습니다. ‘잔액이 충분하면 결제 진행’처럼 비교 결과에 따라 다음 실행 경로가 바뀌는 것입니다.
CPU의 일은 계산뿐 아니라 데이터 이동과 조건 판단, 실행 흐름 변경까지 포함합니다.
3. 계산 장치·레지스터·캐시는 각각 무엇을 할까요?
CPU 안에서는 역할이 다른 회로들이 함께 움직입니다. 제어 기능은 명령을 해석하고 필요한 동작을 조율합니다. 산술논리연산장치(ALU)는 정수 덧셈이나 논리 연산 등을 담당합니다. 현대 CPU에는 부동소수점이나 여러 데이터를 함께 계산하는 별도의 실행 장치도 있어, 모든 계산을 ALU 하나가 도맡는다고 보면 곤란합니다.
레지스터는 현재 계산에 쓰는 값과 중간 결과 등을 담는 CPU 내부의 작은 저장 공간입니다. 캐시는 명령과 데이터의 일부를 가까이 보관해 더 먼 메모리에 접근하는 부담을 줄입니다. CPU가 필요한 정보를 캐시에서 찾지 못하면 다른 캐시 계층이나 메모리에서 받아와야 하므로 기다림이 생길 수 있습니다. [공식 근거: AWS의 CPU 구성 요소 설명]
레지스터는 요리사의 손에 든 재료, 캐시는 조리대 가까이에 둔 재료, RAM은 더 넓은 재료 보관 공간처럼 생각할 수 있습니다. 가까이 두면 꺼내기 편하지만 놓을 수 있는 양은 제한됩니다. 실제 회로가 재료를 옮기는 방식과 같다는 뜻은 아닙니다.
CPU가 빠르게 일하려면 계산 회로뿐 아니라 필요한 데이터를 제때 공급하는 구조도 중요합니다.
명령은 조리 지시서, 실행 장치는 실제 조리 도구, 레지스터와 캐시는 가까이 둔 작업 공간에 비유할 수 있습니다. 빠른 도구가 있어도 재료를 기다리면 조리가 지연되듯, CPU도 데이터가 늦게 도착하면 실행이 지연될 수 있습니다.
4. 명령 하나가 끝나야 다음 명령을 시작할까요?
기본 흐름을 순서대로 설명했다고 해서, 현대 CPU가 매번 명령 하나를 완전히 끝낸 뒤 다음 명령을 가져오는 것은 아닙니다. 파이프라인은 명령 처리 과정을 단계로 나누고, 서로 다른 명령의 단계를 겹쳐 진행하는 방식입니다.
가령 한 명령을 실행하는 동안 다른 명령을 해석하거나 가져오는 식입니다. 다만 앞 명령의 결과를 기다려야 하거나 필요한 데이터가 늦게 오면 진행이 막힐 수 있습니다. 일부 CPU는 실행 가능한 여러 명령을 함께 처리하도록 설계되어 있습니다. 반대로 명령 하나가 여러 클럭 주기를 필요로 할 수도 있습니다. [공식 근거: Intel의 클럭과 명령 처리 설명]
빨래 한 묶음을 세탁·건조·정리하는 동안, 세탁기가 비면 다음 묶음의 세탁을 시작할 수 있습니다. 여러 묶음의 단계가 겹치면 전체 처리량이 늘지만, 한 묶음의 세탁이나 건조 시간이 사라지는 것은 아닙니다.
CPU는 여러 명령의 처리 과정을 겹쳐 전체 실행 효율을 높입니다.
5. 클럭과 코어 수만 높으면 무조건 빠를까요?
클럭은 CPU 동작의 시간 기준입니다. 3GHz는 1초에 30억 번의 클럭 주기를 뜻합니다. 그러나 1초에 명령을 정확히 30억 개 실행한다는 뜻은 아닙니다. 주기당 처리하는 양과 명령의 종류, 대기 시간 등이 다르기 때문입니다.
코어는 명령을 실행하는 처리 단위입니다. 여러 코어를 활용하면 나눌 수 있는 일을 함께 처리할 수 있습니다. 하지만 앞 단계의 결과가 있어야 다음 단계를 실행하는 작업은 코어 수만큼 그대로 빨라지지 않습니다. 프로그램이 일을 나누는 방식도 중요합니다.
결국 CPU 성능을 이해하려면 클럭, 코어, 실행 구조, 캐시와 메모리 접근을 함께 봐야 합니다. 클럭 숫자 하나만으로 세대와 설계가 다른 CPU의 모든 작업 성능을 비교하기는 어렵습니다. [공식 근거: Intel의 성능 비교 시 고려 요소]
CPU 성능은 ‘얼마나 자주 동작하느냐’와 ‘그 시간에 일을 얼마나 잘 처리하느냐’를 함께 봐야 합니다.
CPU와 GPU의 역할 분담이 궁금하다면 CPU와 GPU의 차이에서 이어서 살펴볼 수 있습니다.
- CPU는 기계어 명령을 가져오고 해석하고 실행하며 프로그램을 움직입니다.
- 실행 장치가 계산을 수행하고, 레지스터와 캐시가 필요한 값과 명령을 가까이 둡니다.
- 파이프라인은 여러 명령의 서로 다른 처리 단계를 겹쳐 실행 효율을 높입니다.
- GHz는 클럭 주기의 빈도이며, 그대로 초당 명령 개수를 뜻하지 않습니다.
- 코어 수와 클럭뿐 아니라 프로그램의 구조와 데이터 대기 시간도 성능에 영향을 줍니다.
Arm — CPU와 명령 실행 단계
AWS — CPU 구성 요소와 실행 과정
Intel — 클럭 주기와 성능의 관계
생활 비유와 2+3 예제는 이해를 돕기 위한 가상의 상황이며, 실측·사용자 후기가 아닙니다.